基本的配置:
- nvl最大到72,可以根据调度来配置,选择同一个rack上有多少台机器,比如nvl4, nvl8等
-
分析fsdp/ep下的带宽
- attn等参数量小,并非带宽bound先不分析。并且可以调小attn fsdp group size来降低网络的要求
- GB200上,nvlink带宽理论是900GB,考虑协议的消耗,按照75%算,就是675GB
-
单卡挂2块RDMA网卡,一块是400Gbps
- 单个tray的聚合通信带宽就是 400Gbps * 2 * 4(gpu) / 8 = 400GBps
-
按照0.95 overhead来计算,预期使用的带宽就是 380GBps
FSDP group size <= nvl
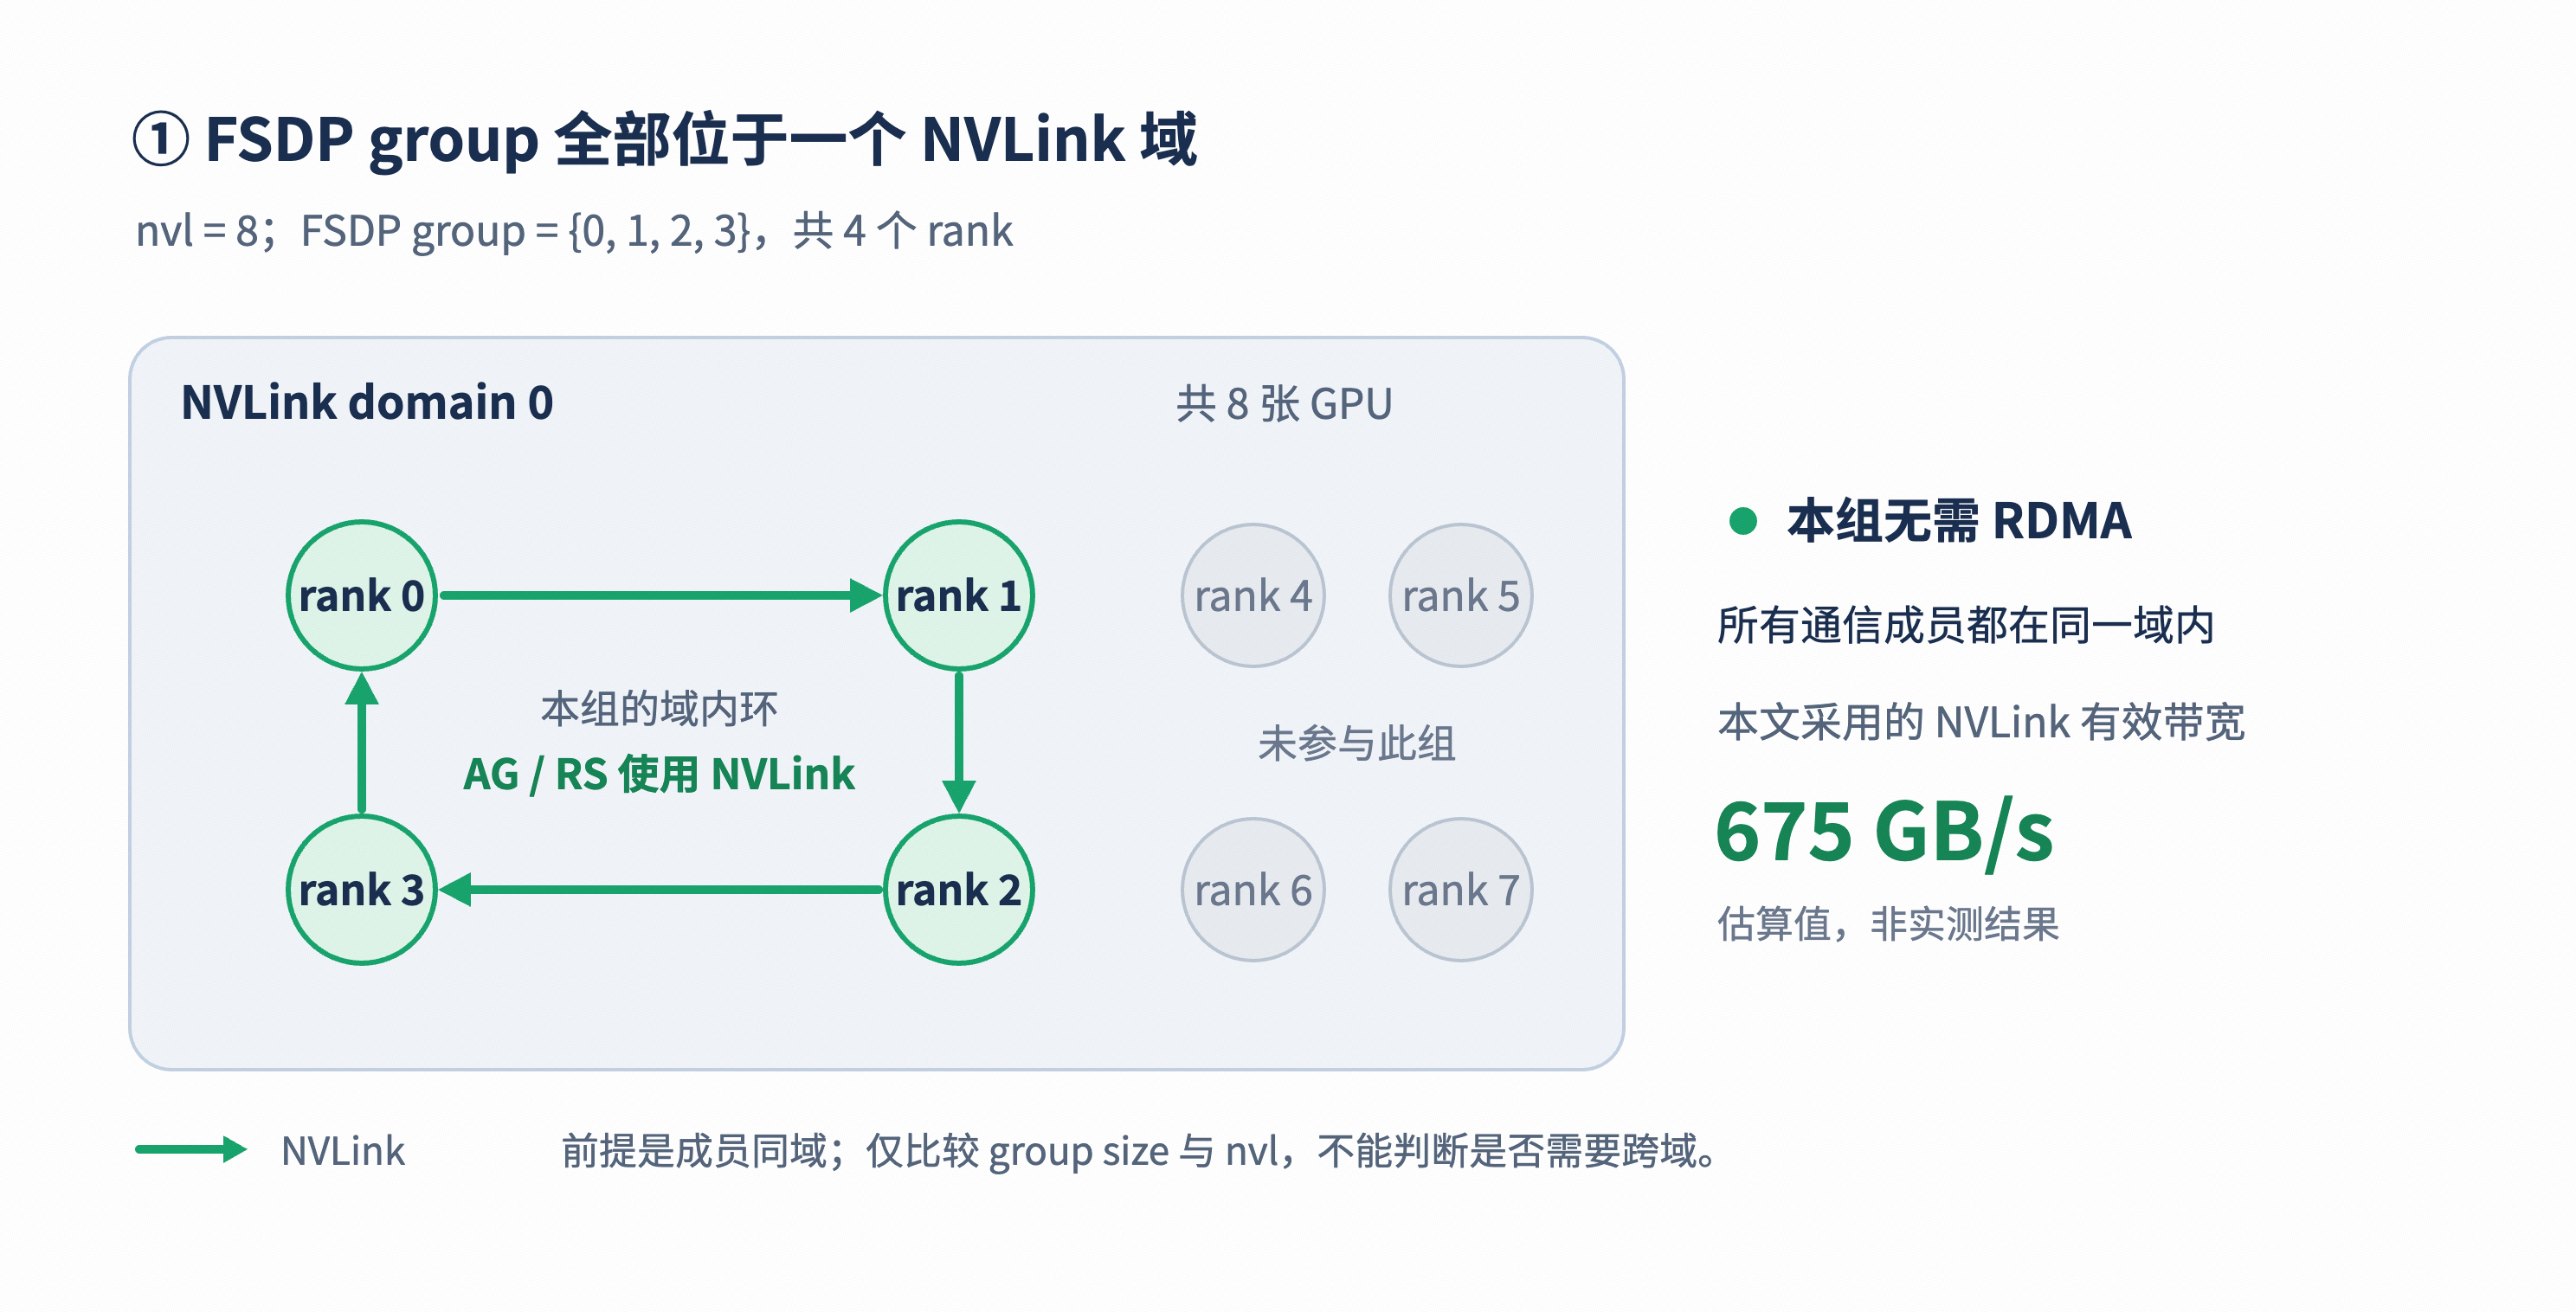
最简单的情况下,FSDP group size < nvl,此时通信发生于nvl domain内,带宽就是nvlink的带宽 675GB。不过这种情况相对较少,因为大规模下fsdp group size不会开这么小。
图 1:组内所有成员都位于同一个 NVLink 域。 这里画出 nvl=8、实际 FSDP group={0,1,2,3} 的情况;仅比较 group size 与 nvl,不能代替对成员布局的判断。
FSDP group size > nvl
Fsdp group size > nvl的情况下,需要考虑ep size:
Ep size <= nvl
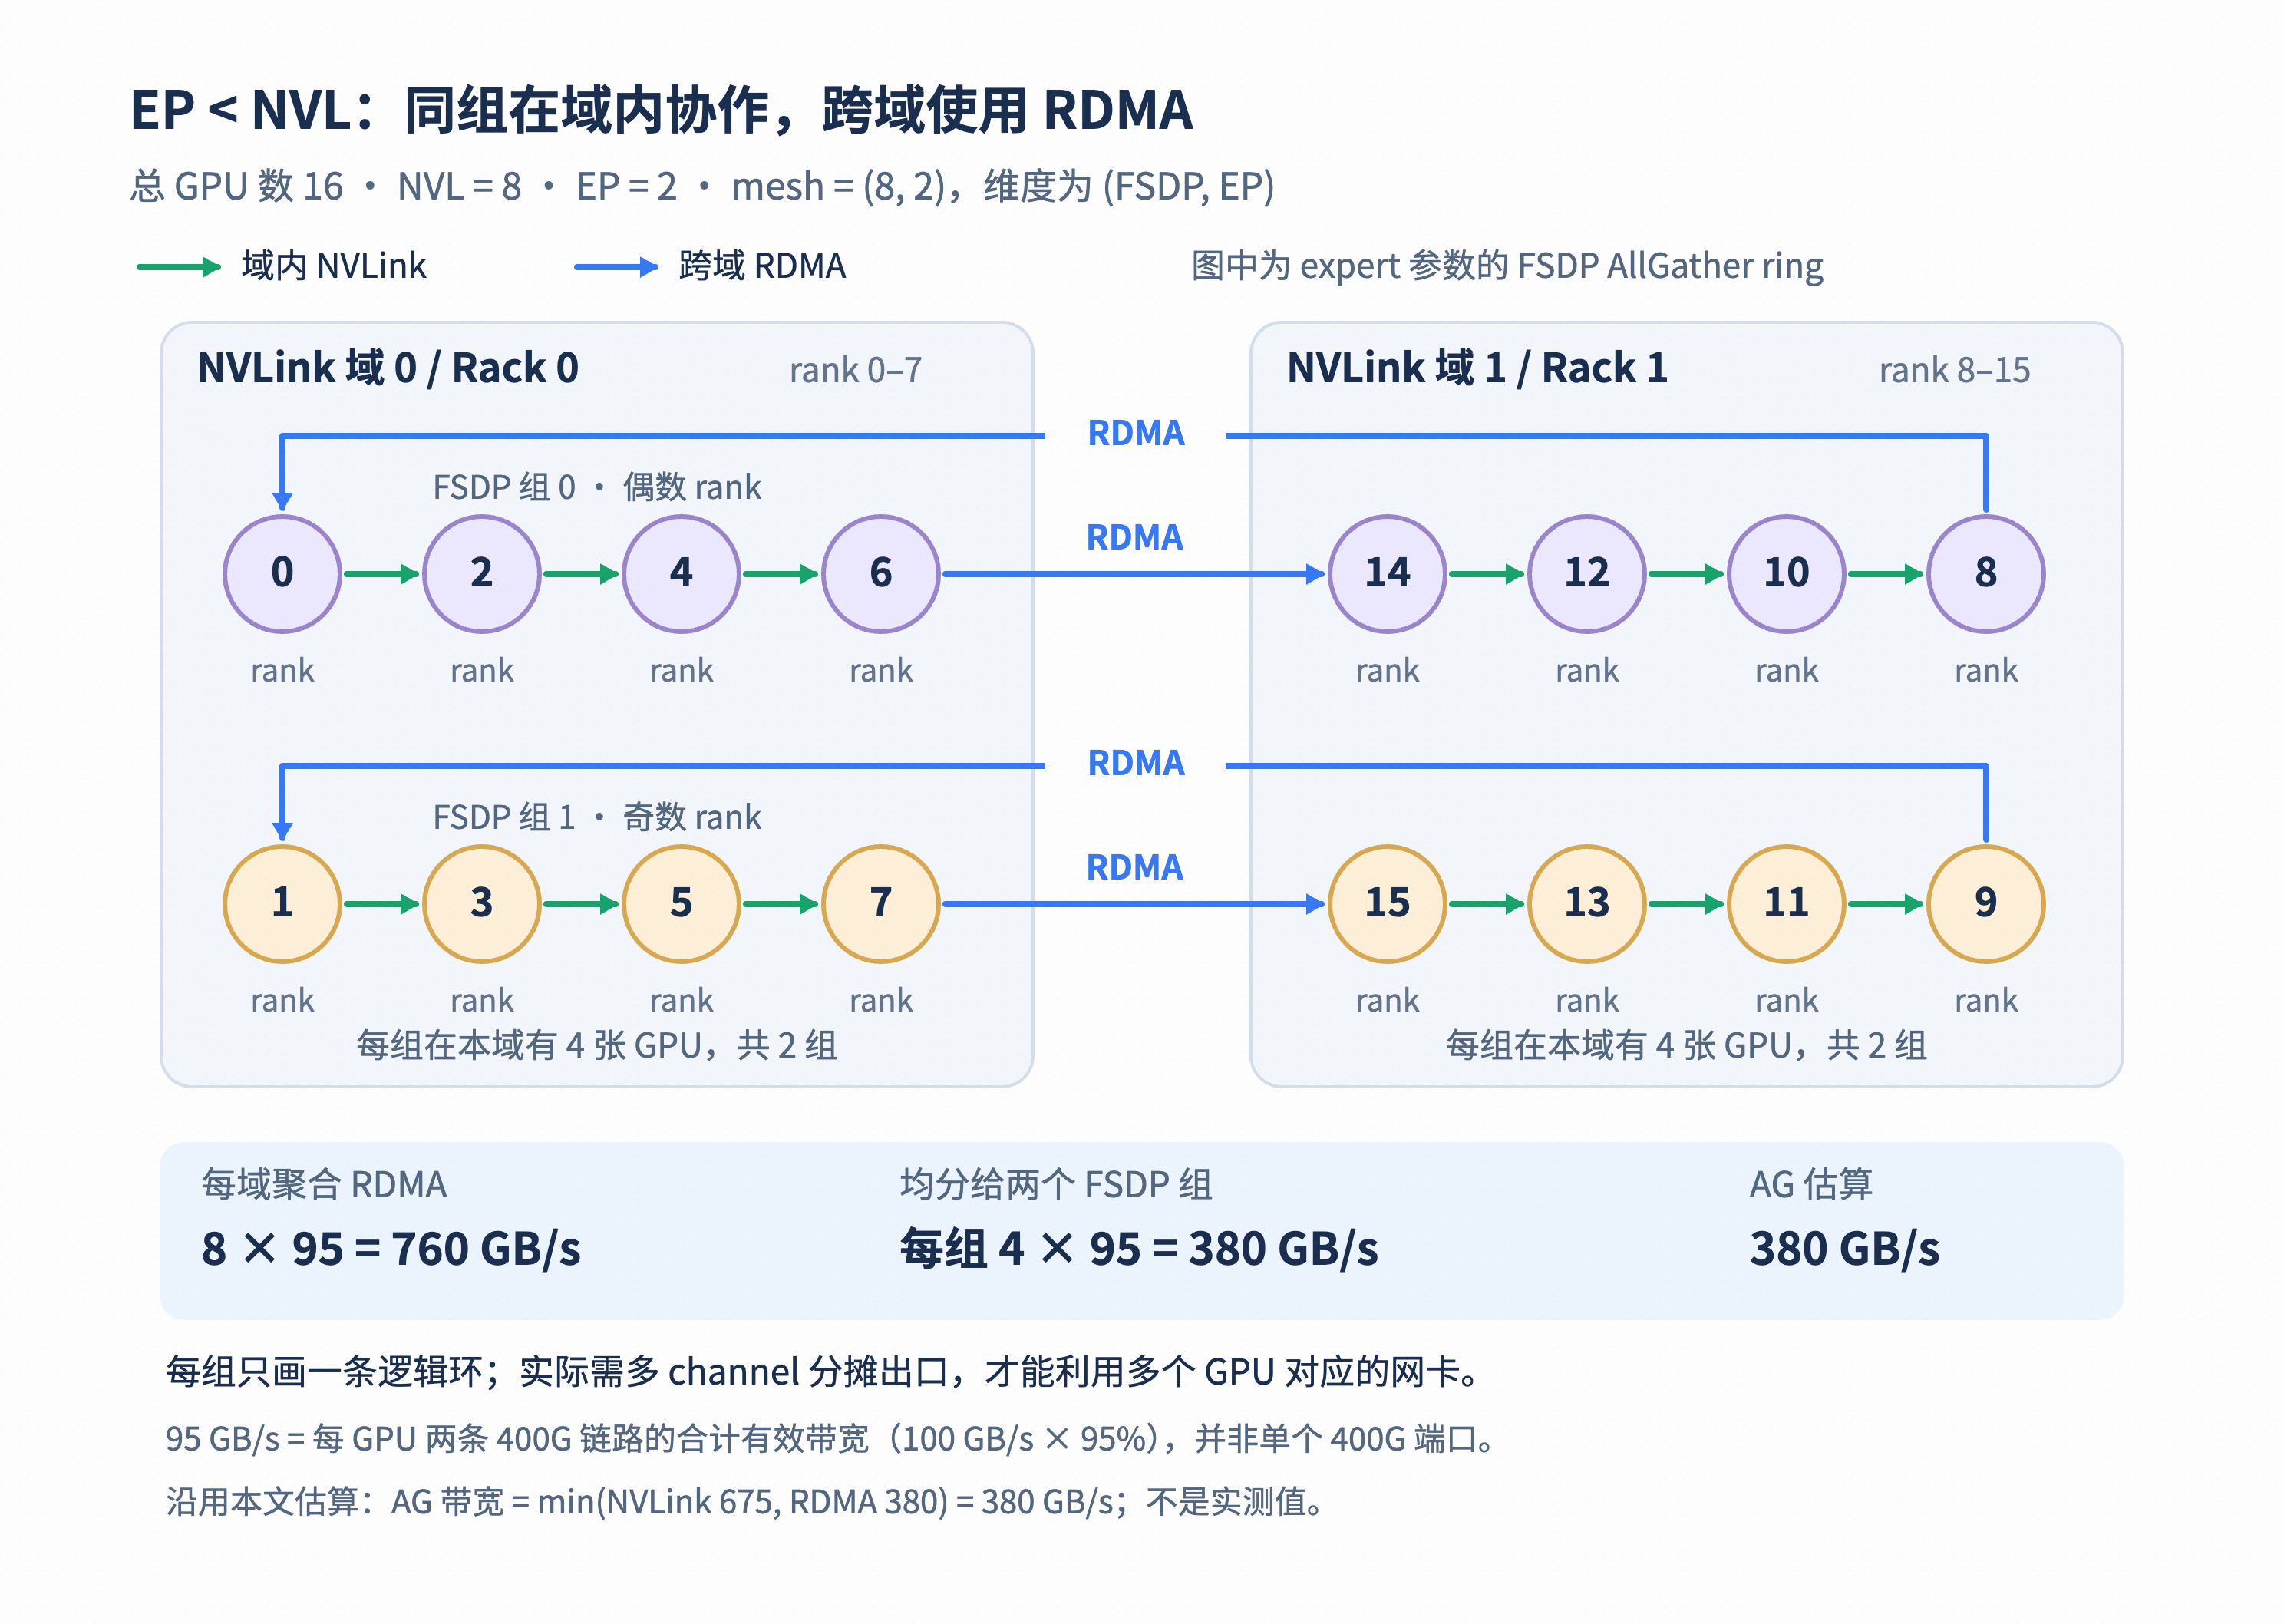
- 此时至多有ep_size个跨越rack(nvl)的ring
-
这ep_size个ring,共享rack之间的聚合RDMA带宽。聚合带宽为 (nvl / 4) * 380 GBps,因为tray = nvl / 4
-
单个fsdp group的带宽就是 nvl / 4 / ep_size * 380GBps
图 2:EP=2 < NVL=8。 总共 16 张 GPU,mesh=(8,2),维度为 (FSDP,EP)。固定 EP 坐标后有奇偶两个实际 FSDP 通信子组,每组 8 个 rank,其中 4 个位于同一域。这里每组仅画一条逻辑 ring,多 channel 的出口分摊见图 4。
Ep size > nvl
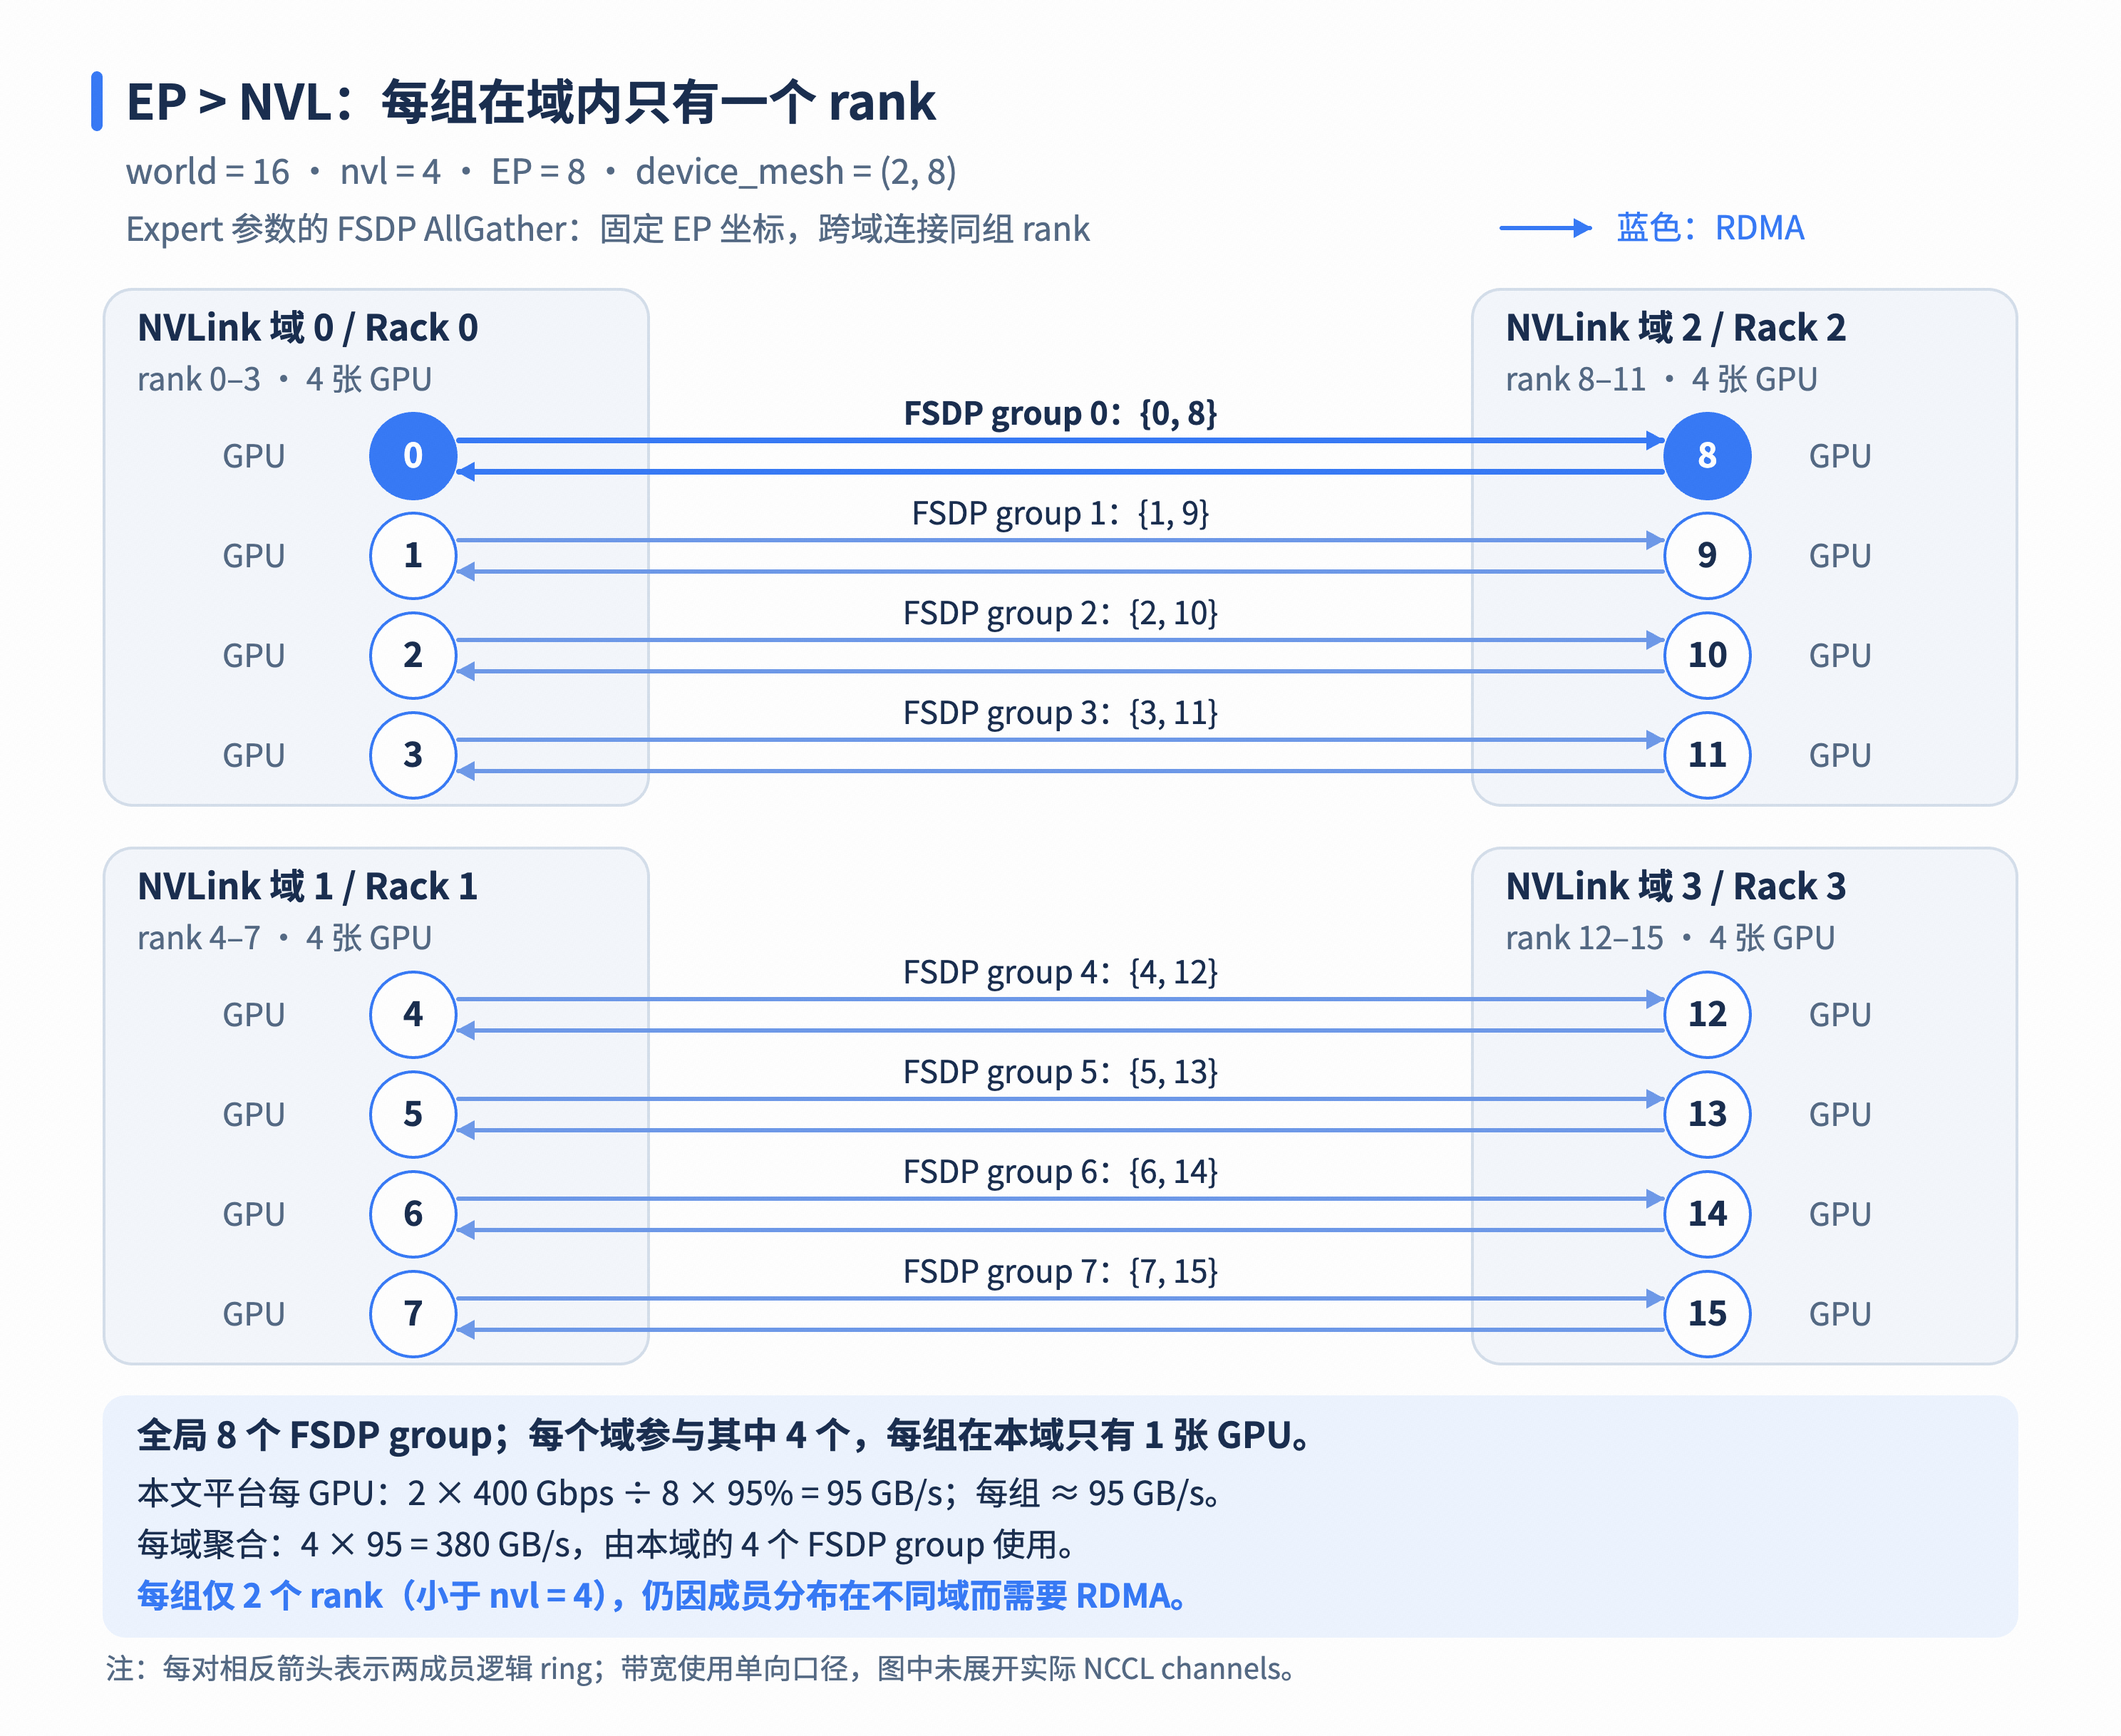
- 此时,nvl内每一个rank都需要跨越rack来做fsdp group的通信,对应nvl个ring
-
那么单个fsdp group带宽就是 380 / 4 = 95GBps
图 3:EP=8 > NVL=4。 总共 16 张 GPU,mesh=(2,8),维度为 (FSDP,EP)。固定 EP 坐标后有 8 个实际 FSDP 通信子组,每组 2 个 rank;每个域参与其中 4 个子组。下图是 expert 参数的 FSDP AllGather,不是 EP 的 All-to-All。
根据上面的公式可以推导一些符合直觉的结论:
- Ep size小,nvl大的时候,RDMA聚合带宽很高,此时通信带宽会bound在nvlink上
-
随着ep size变大,单个fsdp group的通信量减少,同时聚合带宽降低
-
Ep size超过nvl domain的时候,fsdp group通信完全由RDMA接管。带宽固定为单卡的带宽95GBps
实际场景中,可能还需要额外考虑的是:
- Ep size小的时候,RDMA带宽使用率低。并且单个fsdp unit的显存会上涨。
-
随着ep size扩大,带宽会到达一个相对均衡的状态。此时也需要考虑ep本身的开销
-
ep size超出nvl domain时,ep a2a的开销是否会过大
-
Ep size越大,AG的msg size被切的越碎,此时会出现打不满带宽的情况
其他
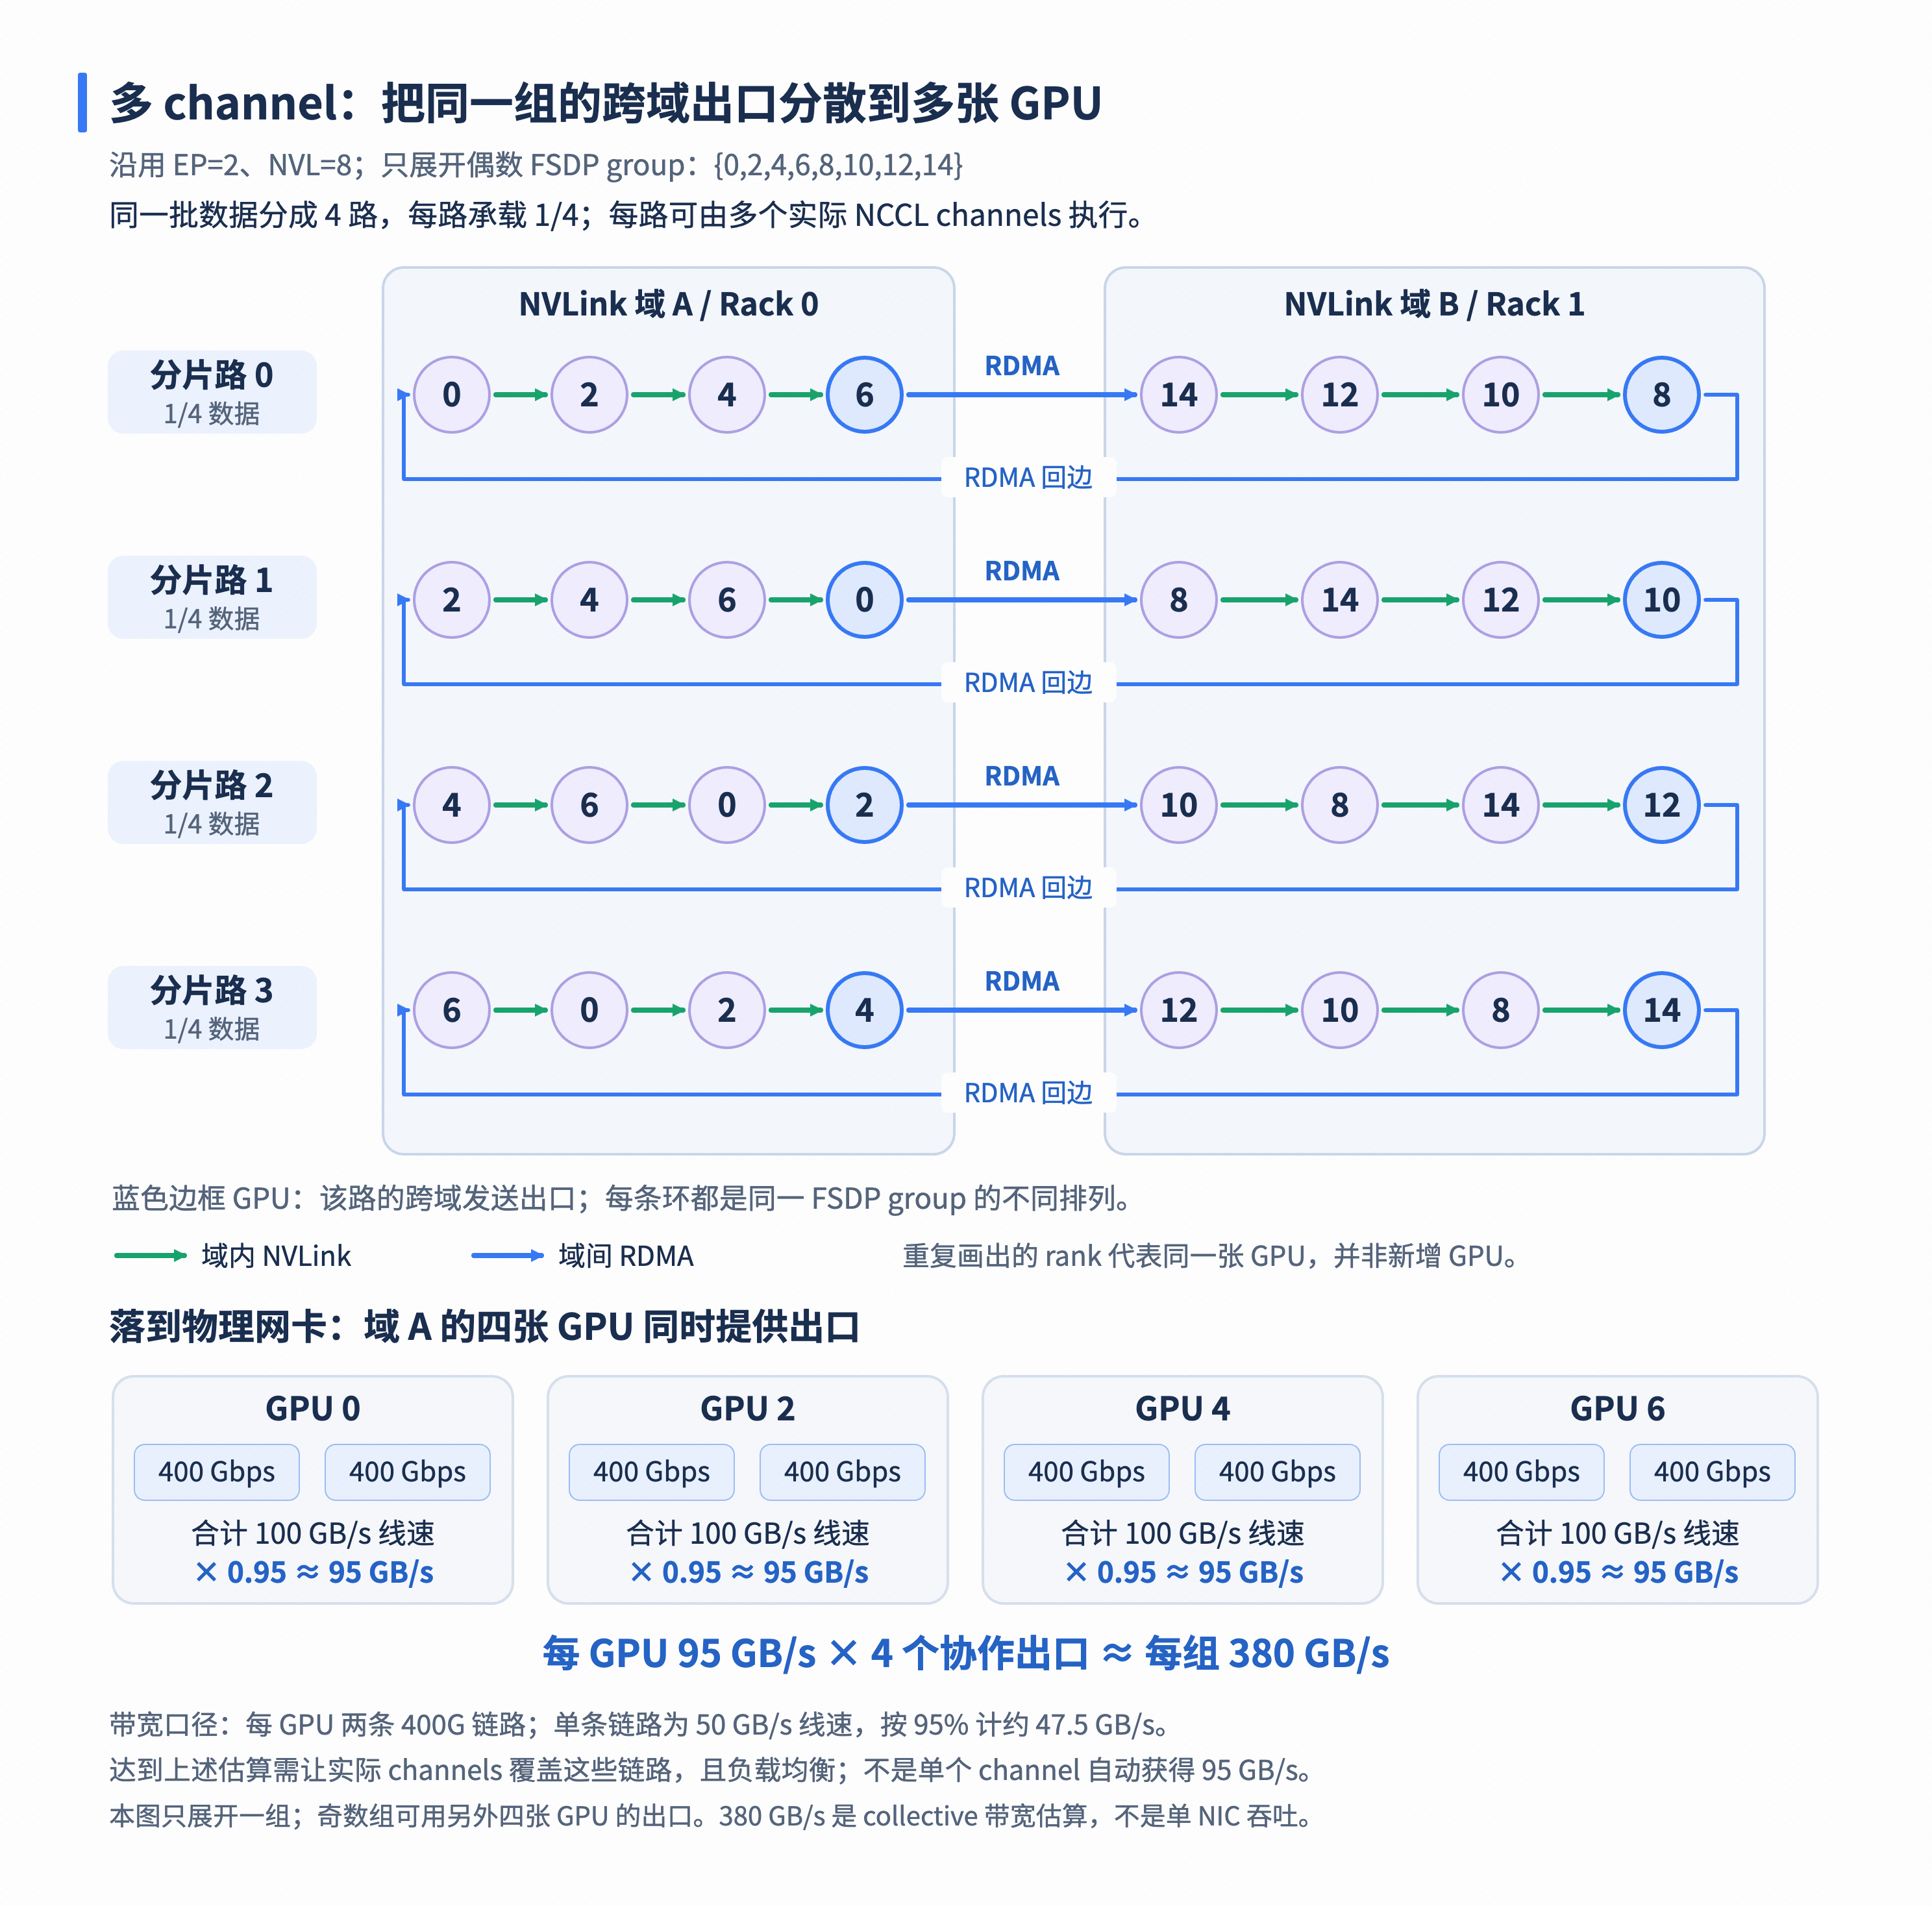
上面聊的时候,省略了聚合带宽的推导。因为实际上网卡时跟着GPU来的,并非整个rack的。而计算的时候是按照rack来计算的。
这是因为nccl可以使用多个channel来使用多张网卡,不同的channel的ring的长相是不一样的。
图 4:多 channel 使用多个 GPU 的网卡出口。 展开图 2 的偶数 FSDP group;按出口画成 4 路分片,每路可包含多个实际 NCCL channels。图中重复出现的 rank 是同一张 GPU。网卡按本文平台的每 GPU 两条 400G 链路计算,95 GB/s 是两条链路合计的有效带宽。

文章评论